一个 0.8M 参数的模型
GPT-4 有大约万亿级参数。今天我用自己的 6 核 CPU(i5-8500,2018 年的 Intel Mac),训练了一个 0.8M 参数的字符级 GPT——大约是前者的百万分之一。
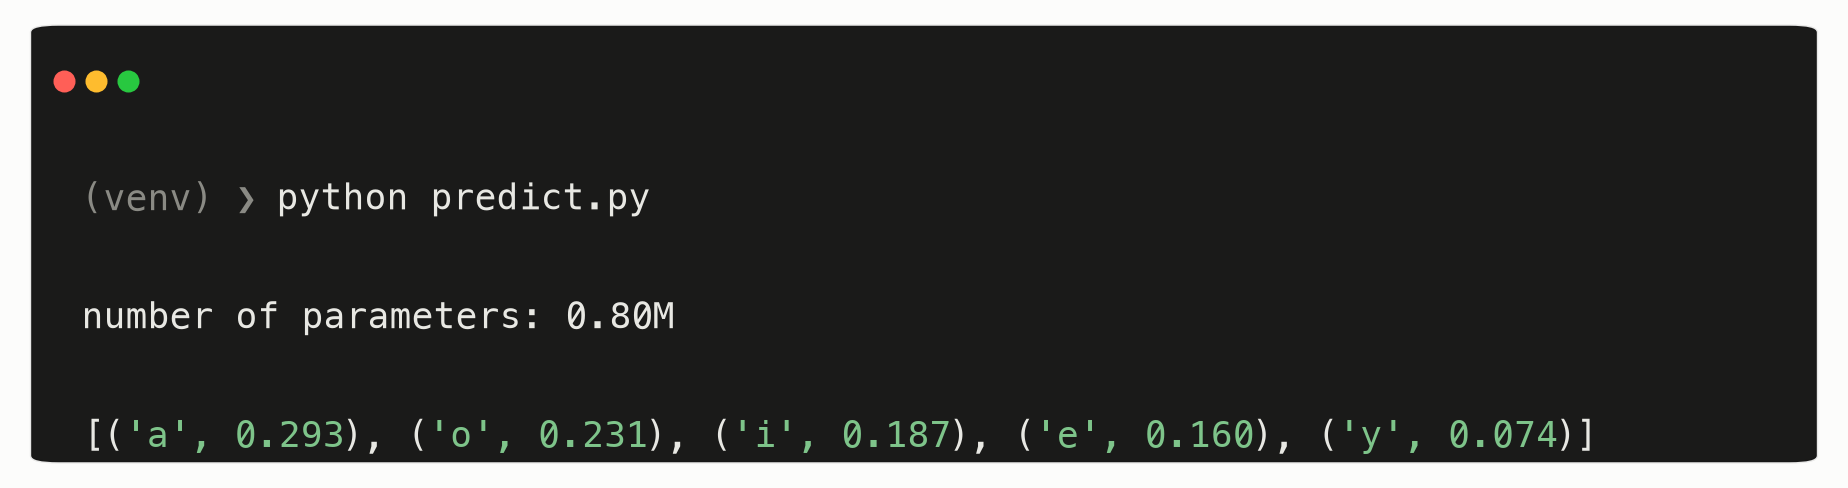
它只有 80 万参数,但已经学会了英语的拼写规律。你给它一个前缀,它输出下一个字符的概率表:
❯ python predict.py
number of parameters: 0.80M
[('a', 0.293), ('o', 0.231), ('i', 0.187), ('e', 0.16), ('y', 0.074)]
意思是:看到 compr,模型认为下一个字符 29% 是 a、23% 是 o、16% 是 e……
这篇文章记录我从零到训练完成的全过程,包括三个折磨过我的坑。如果你也拿着一台"官方已放弃"的 Intel Mac 想入门 LLM,这篇应该能帮你省下一个下午。
字符级语言模型:只做一件事
先讲清楚要训的东西是什么,因为它简单得出奇:
读一段前缀,输出下一个字符的概率表。 没了。
前缀 "compr"
  ↓ 喂进模型(一次前向计算)
输出 65 个字符各一个概率
而"训练"也只有一个循环:
- 从语料里取一段文本,遮住下一个字符
- 让模型猜
- 猜错了 → 算误差 → 调参数
- 重复几百万次
所有大语言模型(包括 GPT-4)底层都在做这件事,区别只是它们的"字符"是 token、模型有万亿参数、语料是整个互联网。字符级模型是理解 LLM 的最小切片——Karpathy 的 nanoGPT 就是为这个存在的:model.py 约 300 行模型定义 + train.py 约 300 行训练循环,全部代码可读。
为什么我突然训这个?因为我在复刻 3Blue1Brown 的交叉熵视频系列——视频里所有"下一个字符概率"的条形图,数据源就是他本地训好的一个 nanoGPT 字符模型。复刻的第一步,就是自己拥有一个。
踩坑实录
坑一:torch 装不上(versions: none)
装依赖的第一步就撞墙了:
pip install torch numpy --index-url https://download.pytorch.org/whl/cpu
# ERROR: Could not find a version that satisfies the requirement torch (from versions: none)
from versions: none 意思是:这个源上一个能装的版本都没有。不是网络问题,是两面墙叠加:
- PyTorch 从 2.3 起不再给 Intel Mac(x86_64 macOS)编译 wheel——官方文档里 Apple Silicon 的 MPS 加速写得热热闹闹,Intel 用户直接被排除在名单外
- 最后一个支持 Intel Mac 的 torch 2.2.2,只兼容 Python 3.8–3.11;而我系统里的 Python 是刚发布的 3.14
也就是:CPU 源上任何一个 torch 版本,都无法同时满足"Intel Mac"和"Python 3.14"两个条件。
解法:装一个 Python 3.11 来建虚拟环境,并锁定历史版本。
brew install python@3.11

cd nanoGPT
python3.11 -m venv venv
source venv/bin/activate

# 锁版本是关键:2.2.2 是 Intel Mac 的最后一批 wheel
pip install --upgrade pip
pip install "numpy<2" torch==2.2.2 --index-url https://download.pytorch.org/whl/cpu
验证:
python -c "import torch; print(torch.__version__)"
# 2.2.2
三个细节值得展开:
--index-url是换下载源:默认 PyPI 上的 torch 捆绑 CUDA(NVIDIA 显卡驱动,2GB+),CPU 源上的只有 ~200MB,其中专门有macosx_x86_64架构的 wheelnumpy<2必须锁:torch 2.2.2 编译时 numpy 2 还没发布,混装会报_ARRAY_API not found- 文件名就是说明书:装好后能看到
torch-2.2.2-cp311-none-macosx_10_9_x86_64.whl——cp311(Python 3.11)+x86_64(Intel Mac),两个条件都满足
坑二:venv 的三个坑
Python 虚拟环境(venv)相当于每个项目独立的 node_modules——但它的机制不如 npm 直觉化,我一天之内踩满了:
坑 1:新终端要重新激活。 source venv/bin/activate 只对当前终端会话生效,新开窗口就失效。症状是明明装了包,import 却报 ModuleNotFoundError——因为你装进了沙盒,import 却跑在系统 Python 里。判断自己是否在沙盒里,看提示符有没有 (venv) 前缀,或者:
which python
# 在沙盒里: .../nanoGPT/venv/bin/python  ← 路径里有 venv 才算数
# 不在:     command not found: python    ← macOS 根本没有裸的 python 命令
坑 2:换 Python 版本必须重建沙盒。 venv 是跟着创建它的 Python 版本走的。我先用 3.14 建了沙盒、装好了包,发现要换 3.11 时只能拆了重来:
deactivate
rm -rf venv
python3.11 -m venv venv    # 重建
坑 3:python 和 python3 在沙盒内外指向不同。 激活后两个都指向沙盒的 3.11;没激活时 python3 是系统的 3.14,python 则不存在。
坑三:KeyError: tensor(39)
训练完成后写了个小脚本读概率表,又遇到一个类型坑:
top = probs.argsort(descending=True)[:5]
print([(itos[i], round(probs[i].item(), 3)) for i in top])
# KeyError: tensor(39)
itos 是个普通字典,键是 int;而 PyTorch 的排序结果里装的是 tensor(39)——值看着一样,类型不是一回事,字典查不到。修法是显式转换:
print([(itos[int(i)], round(probs[i].item(), 3)) for i in top])probs[i] 能用 tensor 索引(那是 PyTorch 自己的容器),itos[i] 不能(那是 Python 的字典)——同一个下标,容器不同,规则就不同。
训练:看 loss 下降,就是看模型在学习
数据用的是 Karpathy 教程里最经典的 tiny shakespeare(一部莎士比亚剧本集,1MB):
curl -o data/shakespeare_char/input.txt https://raw.githubusercontent.com/karpathy/char-rnn/master/data/tinyshakespeare/input.txt
python data/shakespeare_char/prepare.py
# length of dataset in characters: 1,115,394
# vocab size: 65          ← 模型的世界观里只有这 65 种字符
# train has 1,003,854 tokens
# val has 111,540 tokens
训练命令直接用 nanoGPT README 里「I only have a macbook」一节的 CPU 配方:
python train.py config/train_shakespeare_char.py \
  --device=cpu --compile=False \
  --eval_iters=20 --log_interval=1 \
  --block_size=64 --batch_size=12 \
  --n_layer=4 --n_head=4 --n_embd=128 \
  --max_iters=2000 --lr_decay_iters=2000 \
  --dropout=0.0 \
  --out_dir=out-shakespeare-char
i5-8500 跑了约 20 分钟,每轮输出一个 loss 数字:
iter 0:    loss 4.28    ← 开局:ln(65) ≈ 4.17,约等于对 65 个字符均匀乱蒙
iter 100:  loss 2.31    ← 快速学会了 th、he、the 这类高频组合
...
iter 2000: loss 1.70
step 2000: train loss 1.7648, val loss 1.8857
从 4.17 乱蒙到 1.89——这 2.28 的下降就是"学习"本身。
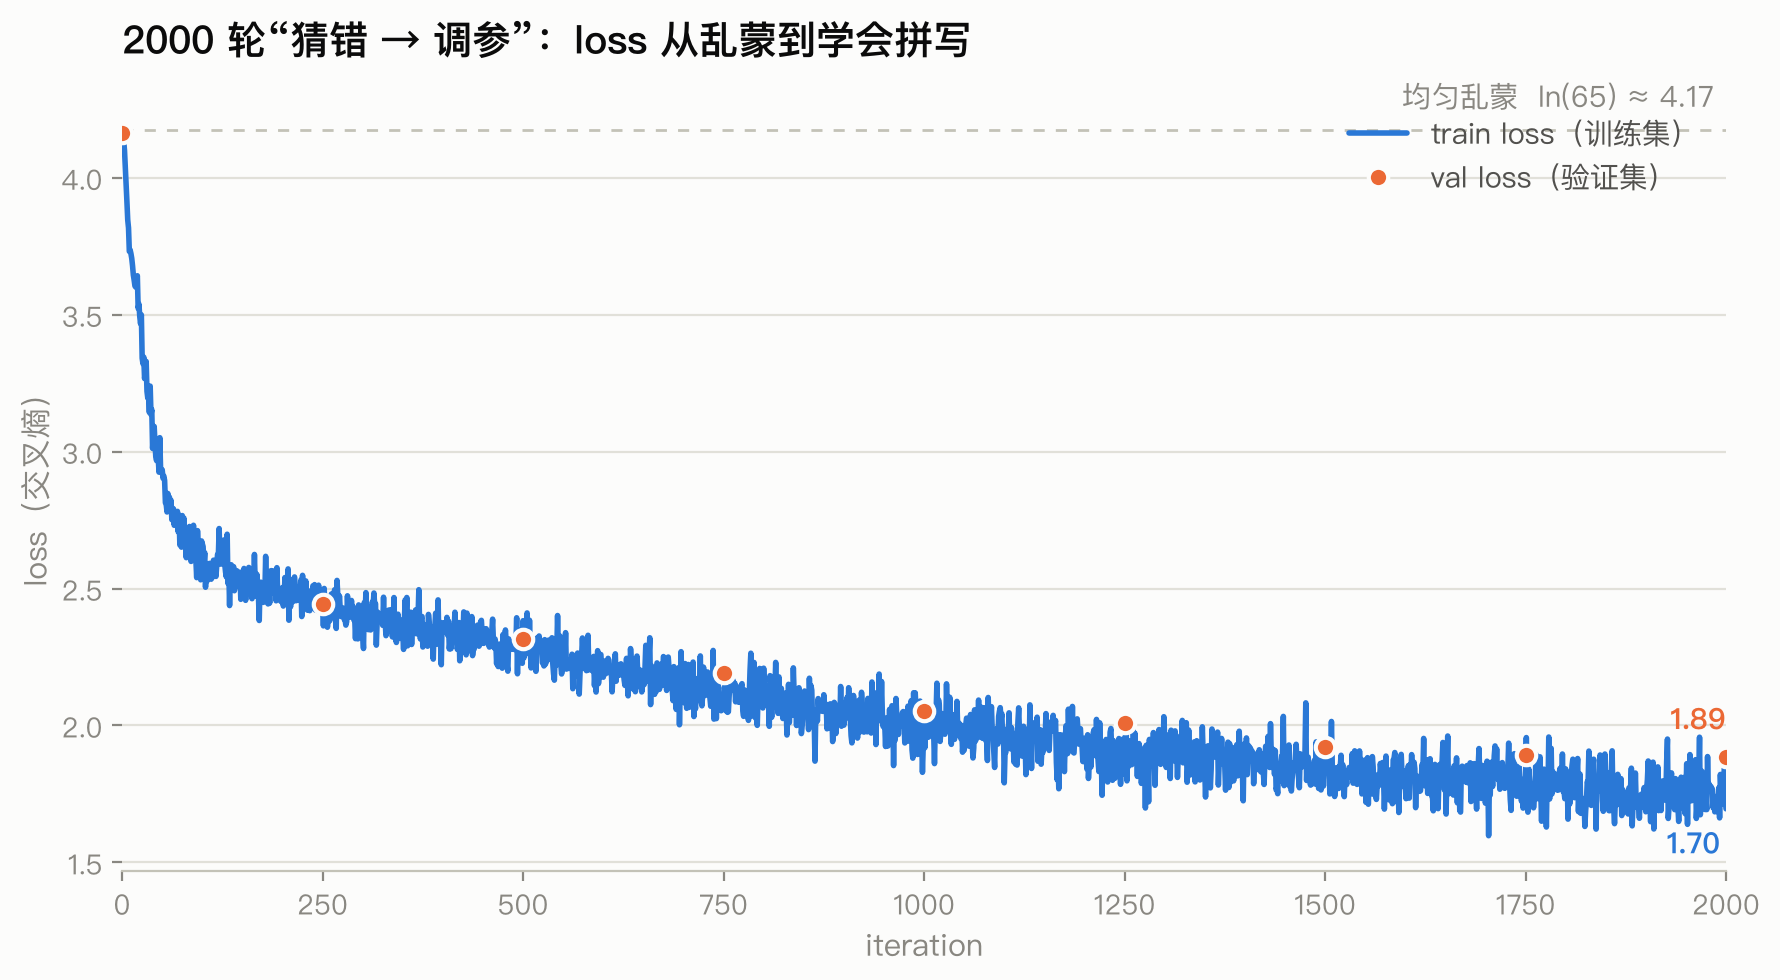
其中 val loss(考试卷,模型没见过的数据)1.8857,和 README 用同样配方得到的 1.88 几乎完全一致——复现成功的踏实感,比什么都重要。
train loss(1.76)略低于 val loss(1.89)也正常:模型对见过的数据当然更熟,但差距不大,说明没有死记硬背。
最有意思的发现:模型是语料的画像
回到开头那个概率表。你可能注意到了一个问题:
compr后面不应该是 e 吗?compress、comprehend、comprehensive……
但模型给的答案是:a > o > i > e。是 bug 吗?
不是。这个模型读的是莎士比亚。 莎士比亚时代罕用 compress、comprehend 这类词——他爱写的是 complain、complexion(注意这些是 compl 后面)。而在英语的普遍规律里,r 后面接 a、o、i 本来就常见。模型没有错,它只是忠实反映了一本 17 世纪剧本集的统计面貌。
而 3Blue1Brown 的模型读的是 Wikipedia,对同样的前缀就会笃定地给出 e。
换语料,模型就换性格。 这是我今天学到的最生动的一课:所谓"语言模型",本质上是它读过的文本的统计画像。这个现象也顺便演示了一个后续要用到的概念——如果让模型处理它没见过的组合,它只能给出"平庸的猜测",而这种不确定性的大小,正是香农熵要度量的东西。
它接下来要去哪
训练完成后我把模型输出的概率分布存成了 JSON:
# gen_dists.py(核心逻辑,完整脚本见 nanoGPT 目录)
PREFIXES = ["compr", "the ", "to be", "math", "comp", "sha"]
out["dists"][prefix] = [round(float(p), 5) for p in probs]  # 每个前缀一条 65 维概率数组
json.dump(out, open('dists.json', 'w'))从这一步起,训练环境和渲染环境正式解耦:动画侧只读 JSON,永远不需要 import torch。这个模型将成为我复刻 3Blue1Brown 交叉熵系列的概率源——它会亲手"画"出熵、交叉熵、算术编码的所有画面。
这是 AI 学习系列的第一篇。下一篇:熵与最优编码——为什么"猜得准"和"压得小"是同一件事。
相关资源
- 📦 nanoGPT — 本文的训练引擎(README 自带 CPU 配方,注意它已被作者标记 deprecated,但作为学习教材依然一流)
- 📺 Karpathy《Let’s build GPT》 — 2 小时从零手写 nanoGPT,想懂内部就看它
- 📖 3Blue1Brown《But what is cross-entropy?》 — 本系列的灵感来源