一个我天天看、却讲不清的数字
上一篇我训了一个 0.8M 参数的字符级 GPT。训练的十几分钟里,屏幕上一直往下滚一个数字:
iter 1900 train loss 1.79 val loss 1.8857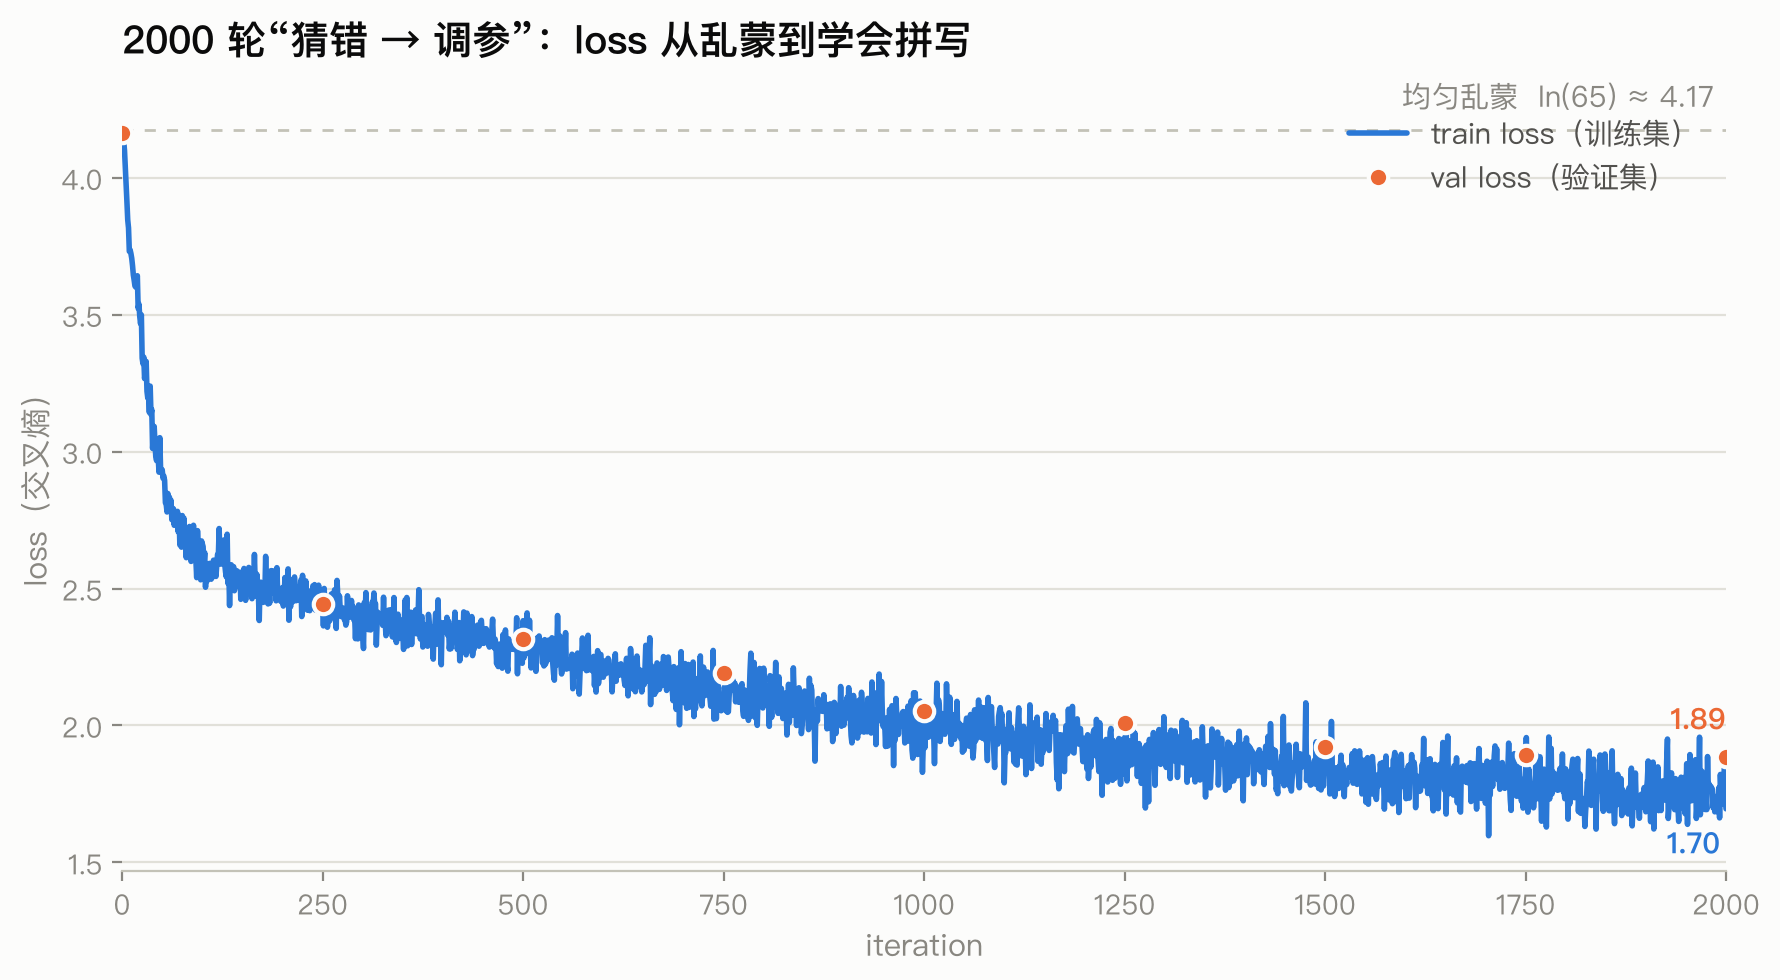
我知道它该变小,变小了说明模型在进步。但如果有人问我"这个数字到底是什么",我只能说"是损失函数"——等于没说。
这个 loss 的学名叫交叉熵。今天我把它拆到了底:不背公式,用 70 行 Python 把它涉及的每个数字亲手算了一遍。算完之后再看那个 1.8857,感觉完全变了。
先从猜字符说起:概率换刀数
我的模型看到 compr 时,会说"下一个字符 29% 是 a"。但概率本身没法直接当账单付——我们需要把它换算成一种能数的东西:是非题的个数。
想象猜字符游戏:我心里想一个字符,你用"是/否"的问题来猜,规则是问题必须切成对半("它在 a~m 吗?")。你问几个问题才能猜中?
- 如果这个字符出现概率是 ½ → 一次对半就能锁定 → 1 问
- 概率 ¼ → 两问
- 概率 ⅛ → 三问
规律:概率每减半,多问一问。反过来数,就是"概率 0.293 的字符要问几问"——答案是 1.77 问。这个换算在数学上就是取对数:−log₂(0.293) = 1.77。
所以我叫它"刀数":概率的蛋糕,对半切几刀能切到你那块。
我的模型看到 compr 之后的完整猜测表:
| 下一个字符 | 模型给的概率 | 需要几刀 |
|---|---|---|
| a | 0.293 | 1.77 |
| o | 0.231 | 2.11 |
| i | 0.187 | 2.42 |
| e | 0.160 | 2.64 |
那"平均几刀"?把每种字符的"出场率 × 它的刀数"全加起来——我算了一遍,模型在 compr 之后的平均刀数是 2.53。这个"平均刀数"就是传说中的熵。
熵低 = 模型猜得很集中 = 平均没几刀就能锁定。这是好事。
一个玩具问题:信念错了会怎样?
上面的 2.53 刀有个前提:模型猜得准,概率表和现实差不多。那如果概率表是错的呢?
为了看清楚,我造了一个只有 4 个字符的玩具世界。真实世界长这样:
p = [½, ¼, ⅛, ⅛] (第一个字符一半时候出现,后面越来越稀有)按真实概率造攻略,平均刀数:½×1 + ¼×2 + ⅛×3 + ⅛×3 = 1.75。这是理论极限,省不了了。
现在想象一个自以为是的人。他从没观察过这个世界,坚信四个字符等可能(各 ¼),按这个信念造了攻略:每个字符一律 2 刀。
好,游戏开始:现实按 p 的频率抽签出题,他按自己的攻略付刀数。他的平均开销是多少?
现实出题的人不管你信什么——第一个字符照样一半时候出现。所以他的账单是:
½ 的题 × 2 刀 + ¼ 的题 × 2 刀 + ⅛ 的题 × 2 刀 + ⅛ 的题 × 2 刀 = 2.0 刀不管概率表长什么样,他的每道题都是 2 刀(因为他信了均匀分布),平均就是 2.0。
理论极限 1.75,他花 2.0,多花的 0.25 就是"信念错误税"。
这三个数字各有一个名字:
- 1.75 = 熵 H(p):现实和攻略一致时的平均开销
- 2.0 = 交叉熵 H(p, q):现实按 p 出题、你按 q 缴费的平均开销
- 0.25 = KL 散度 D(p‖q):多缴的税
也就是说,交叉熵 = 熵 + KL 散度。这不是巧合,是定义:税就是"账单减去极限"。交叉熵衡量的从来不是"这个世界多复杂"(那是熵的事),而是"你的信念偏离现实多少"。
逐个字符看税是怎么交的
把 0.25 的税拆到每一单,有个挺意外的发现:
| 字符 | 现实概率 p | 信念 q | 现实是信念的几倍 | 每单多付 |
|---|---|---|---|---|
| 第一个 | ½ | ¼ | 2 倍(他低估了) | +1 刀 |
| 第二个 | ¼ | ¼ | 1 倍(刚好) | 0 |
| 第三个 | ⅛ | ¼ | ½ 倍(他高估了) | −1 刀 |
| 第四个 | ⅛ | ¼ | ½ 倍(他高估了) | −1 刀 |
注意负号!对稀有字符,他其实少付了——他把它们估价 ¼,比真实的 ⅛ 还高,等于主动让利。
那为什么总税还是正的?因为他低估的是常客:第一个字符一半的时候出现,每单多收 1 刀,出场率又是全场最高,这一个洞就填平了所有让利还有富余。
这就是 KL 散度藏得最深的一个性格:你可以对稀有事件随便高估(几乎不罚钱),但对常客的低估是致命的。把公式 Σ p·log₂(p/q) 里那个"商"看清楚——p/q 是"现实是信念的几倍",取对数就变成刀数差,再按 p 加权求和:谁出场多,谁的错配谁买单。
70 行代码验证
光手算不算数,写成代码(对照着看,每个函数就是上面的一笔账):
import math

p = [0.5, 0.25, 0.125, 0.125]   # 现实
q = [0.25, 0.25, 0.25, 0.25]    # 那个自以为是的信念

def entropy(probs):                      # 熵:理论极限
    total = 0.0
    for p in probs:
        if p == 0:
            continue
        total += p * -math.log2(p)
    return total

def cross_entropy(probs_p, probs_q):     # 交叉熵:现实出题,按 q 缴费
    total = 0.0
    for p, q in zip(probs_p, probs_q):
        if p == 0:
            continue
        total += p * -math.log2(q)
    return total

def kl_divergence(probs_p, probs_q):     # KL:税,单独算
    total = 0.0
    for p, q in zip(probs_p, probs_q):
        if p == 0:
            continue
        total += p * math.log2(p / q)
    return total

h_p  = entropy(p)
h_pq = cross_entropy(p, q)
d_kl = kl_divergence(p, q)

print(h_p, h_pq, d_kl)                                   # 1.75 2.0 0.25
assert math.isclose(h_pq, h_p + d_kl)                    # 恒等式成立
print("H(p,q) == H(p) + D(p||q)  ✓")
输出:
1.75 2.0 0.25
H(p,q) == H(p) + D(p||q)  ✓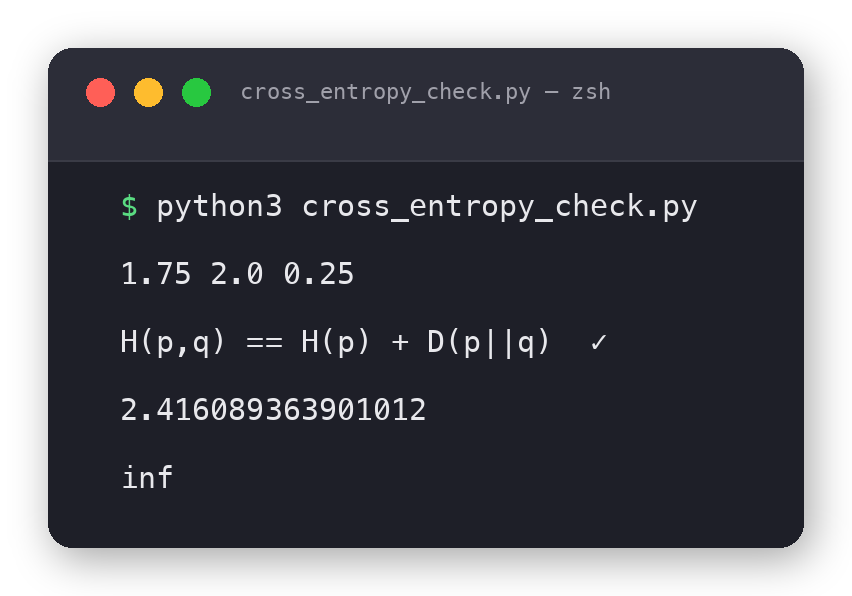
三个细节值得说:
- KL 我单独写了一个求和,而不是直接拿 2.0 − 1.75。如果直接相减,那恒等式检查就变成了自己验证自己,什么都没证明。分开算,浮点误差才会真实出现。
- 正因为浮点误差存在,比较用了
math.isclose而不是==。数值世界里的"相等"永远带容差。 - p = 0 的项直接跳过:现实从不出题的字符,一分钱都不该付。0 乘任何刀数都是 0。
上真家伙:模型两个世界的错配
玩具玩完了,回到我训的模型。它有一个存档文件,里面存着它对各种前缀的猜测表——看到 compr 是一张表,看到 the 是另一张表。我把两张表都读出来对比:
模型看到 compr 后:a(0.29)  o(0.23)  i(0.19)  e(0.16) ...
模型看到 the  后:t(0.11)  s(0.10)  h(0.08)  w(0.07) ...(铺得很开)
(顺带一提:我语料很小,模型居然认为 the 后面几乎不会是空格——这是它的怪癖,不影响今天的主题。)
两张表存在一个 JSON 文件里(我的训练管线把模型的猜测表存成了存档)。读进来只要三行,然后喂给函数:
import json

with open("dists.json") as f:
    data = json.load(f)
alphabet = data["alphabet"]
dists = data["dists"]       # {"compr": [65个概率], "the ": [...], ...}

def kl_on_json(name_p, name_q):
    p, q = dists[name_p], dists[name_q]
    total = 0.0
    for p_x, q_x in zip(p, q):
        if p_x == 0:
            continue
        if q_x == 0:
            return math.inf      # ← 价目表上没有的字符,现实偏出了它
        total += p_x * math.log2(p_x / q_x)
    return total

print(kl_on_json("compr", "the "))   # 2.416089363901012
print(kl_on_json("the ", "compr")) # inf重点来了:同一个公式,换个方向,从"贵"变成了"不可能"。
- D(compr‖the ) = 2.416:错配很贵,但还能活。只要肯多付 2.4 刀,游戏照样进行。
- D(the ‖compr) = inf:直接破产。
the的世界里会出现的字符中,有 9 个(3、B、C、H、L、Q、S、X、Z)在 compr 的价目表上根本不存在(概率为 0)。现实掏出来一张"你攻略本上没有的题",这一单的刀数是无穷——整个平均直接无穷。
这就是"KL 散度不可交换"的具象含义。一个方向的错误是亏钱,另一个方向的错误是世界规则不允许。反过来看 D(compr‖the ) 为什么有限:compr 认为可能的每个字符,the 都多少给了点概率——攻略本再差,至少没有缺页。
谜底:loss 就是那张税单
最后回到 1.8857。
训练的时候,比"信念错配"更极端:下一个字符已经发生了。比如真实写的是 e,那"现实"就 100% 是 e、其他字符全是 0。代入交叉熵的求和式,只剩一项活着:
loss = 1 × −log₂ q(e) = 模型给"实际发生的字符"几刀模型给 e 的概率是 0.5?付 1 刀。给 0.01?付 6.6 刀。每一步训练,都是现实刚出一个字符,模型按自己的信念当场买单。 训练就是一万局一万局地改攻略本,让账单越来越接近理论极限。
我的 val loss 1.8857,单位是 nat(PyTorch 默认用自然常数 e 取对数,而不是 2)。换算成刀数:1.8857 × 1.44 ≈ 2.72 刀/字符。模型每读一个字符,平均要交 2.72 个是非题的钱。
所以训练时屏幕上往下掉的数字,说的从来不是"模型有多差",而是一句很具体的话:
模型按它现在的信念,给现实缴的平均税,还差多少到头。
下一步
交叉熵回答"信念值多少钱",下一步自然的问题是:这笔钱能不能真的付出去?还真行——把每个字符的刀数连乘起来,一整段文本可以压缩成 0 到 1 之间的一个数。文本即数字,这就是算术编码,Shannon 在 1948 年那篇论文里埋的伏笔。等我学完再写下一篇。
完整脚本就是文中两段代码拼起来的,加起来不到 70 行,欢迎亲手跑一遍——1.75、2.0、0.25,三行数字比十段定义都好使。