昨天我在 Intel Mac 上训了一个 0.8M 参数的迷你 GPT。今天我跟着 3Blue1Brown 的信息论课学熵,卡在一个所有教材都一笔带过的公式上:
−log₂p
公式我"看过"很多年。但被要求报出具体数字时,我发现自己根本不懂它为什么长这样。这篇记录我从卡住到想通的全过程——全程只用加减乘除,和一句话版的 log 定义。
log 只有一句话的含义
log₂(x) 只有一个含义:2 的几次方等于 x。
- log₂(8) = 3,因为 2³ = 8
- log₂(1/4) = −2,因为 2⁻² = 1/4
不做任何延伸,就这一句话。
为什么 log₂p 前面有个负号
概率 p 是个 0 到 1 之间的数。而 2 的正次方全部 ≥ 1(2¹=2,2²=4……)。想把结果压到 1 以下,指数只能取负数。
所以只要 p < 1,log₂p 就必然是负的。加个负号把它掰正。
我踩过的坑是在负号上死磕直觉——完全没必要。负号是符号卫生:先算 log,发现是负的,加负号让"信息量"这个数为正而已。直觉应该在别处找。
直觉在两条数轴上:上轴是指数(−5、−4、−3……3,均匀排开),下轴是对应的数值(1/32、1/16、1/8……8)。把上下连起来看,你会发现 p < 1 的数全部住在指数 0 的左边。"负"不是什么怪事,就是它们的住址。
把两条数轴立起来,就是一张二维曲线图——横轴放数值 x,纵轴放 log₂x:
把"住址"和曲线对照着看:概率 p 永远住在 0 和 1 之间,对应图上浅蓝的那一小格——这段曲线全部躺在 x 轴下面,纵坐标全是负数。这就是"log₂p 必为负"在图上的样子。x = 1 是分水岭:2⁰ = 1,正好落在 y = 0 上。
bit 就是刀数
真正让我开窍的换算:把信息量想成切蛋糕的刀数。
从 1 出发对半切:
- 切 1 刀 → 1/2
- 切 2 刀 → 1/4
- 切 3 刀 → 1/8
- ……
把概率 p 切到这么小需要几刀?答案是 −log₂p。
那 bit 又是什么?想象猜一个人心里想的数,规则是你只能问"是不是大于 50"这种是非题,每次提问都把剩下的范围砍掉一半。切一刀 = 问一个问题 = 剩下的可能性减半。
所以 bit 可以理解成是非题的数量:一个事件的信息量,就是平均要问几个是非题才能锁定它。1 bit,就是一刀,就是一个问题。
用我自己的模型报数
空谈不如算数。我拿昨天训的模型实测(65 个字符的字符表):
前缀 "compr",下一个字符是 'a',模型给的 p = 0.293:
−log₂(0.293) ≈ 1.77 bits —— 模型很有把握,平均不到两个是非题就能锁定
前缀 "the ",下一个字符是 't',p = 0.108:
−log₂(0.108) ≈ 3.21 bits —— 没那么有把握,要多问几个
这里我栽过一次:第一次我报了 9.26。9.26 = 1/0.108,那是 1/p——块数(p 这么大的块,1 里面能塞多少块),不是刀数。块数回答"平均要抽多少次才能抽中它",刀数回答"几个是非题能锁定它"。熵用的是后者。
还有一个反直觉的数:p 从 0.293 掉到 0.108,掉了不到 3 倍;bits 只从 1.77 涨到 3.21,涨了 1.44。log 把倍数世界翻译成刀数世界——概率乘除,信息量加减。
最极端的情况:某个字符 p = 0.00001,比 'a' 难得 29274 倍。要多少是非题?2¹⁵ = 32768,所以只需 16.61 bits。
难得三万倍,只多问十五个问题。
"温和"不是妥协,是对半砍这条规则的物理事实——每问一句就砍掉一半,15 刀就能从三万砍到一。
六个前缀,六种"出乎意料"
拿这套公式实测自己模型的六个前缀,条件熵(每个前缀下、所有可能下一字符的平均信息量)长这样:
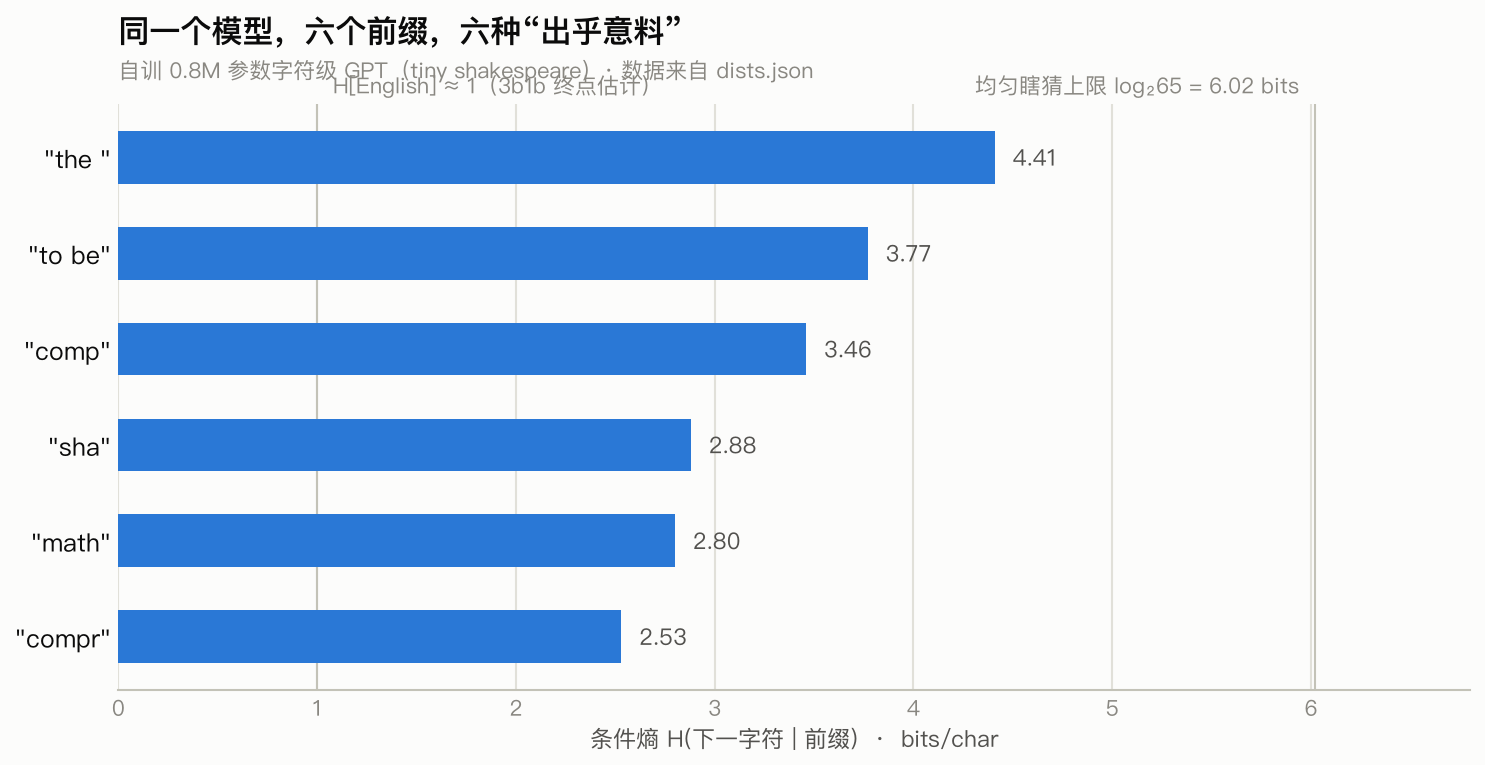
"the " 最高(4.41)——the 后面什么都可能接,模型心里没底;"compr" 最低(2.53)——猜到这个前缀,下一个字符基本锁定。上下文越长,不确定性被收得越窄:"comp" 是 3.46,"compr" 降到 2.53,一路推到极限,就是英语的真实熵 H[English] ≈ 1 bit——3b1b 系列的终点数字。
这里我犯过一个很典型的错:我说"compr 熵低,是因为 compr 出现的概率高"。
不对。 熵看的从来不是前缀本身多常见(p(前缀)),而是它把下一个字符的不确定性收窄了多少(p(下一字符|前缀))。这个区分,恰好就是交叉熵损失的入口——训练时模型逐字符看的正是 p(下一字符|前文)。
熵就是一本账
有了 bits,熵只剩一步:按概率加权平均。
把 bits 想成价格,p 想成购买频率,熵就是这本账的日均开销:
| 字符 | 价格(bits) | 频率(p) | 对账本的贡献 |
|---|---|---|---|
'a' | 1.77(便宜) | 0.293(天天买) | 0.519 |
'D' | 16.61(天价) | 0.00001(十万次一遇) | 0.000166 |
'D' 贵到离谱,但对账本几乎没影响。熵是日常开销的平均——奢侈品十年买一次,不左右账本。
前缀 "compr" 的总账:H = 2.53 bits/char。作为对照,如果 65 个字符均匀分布,上限是 log₂65 ≈ 6.02。模型靠上下文把 6.02 压到了 2.53。
最后的反例:如果不用 log 呢?
这是我今天最爽的一个"啊哈"时刻。假设有人较真:信息量凭什么用 −log₂p,用 1/p 不行吗?块数更直观啊。
算一遍就知道 1/p 会带来什么。熵的定义是"每项 = p × 信息量,再求和"。如果信息量 = 1/p:
每一项都是 p × (1/p) ≡ 1
每一项恒等于 1,求和永远等于字符表大小——H 恒等于 65。均匀分布是 65,"compr" 后面几乎是确定的也还是 65。分布的形状信息整个丢掉了。
而用 −log₂p,概率悬殊 29274 倍的两个字符,对账本的贡献是 0.519 vs 0.000166——差距被诚实地保留了下来。
log 不是众多选择中的一个,是唯一让加权平均仍然反映分布形状的选择。
今天学的这一切只需要加减乘除和"2 的几次方",但它已经通向一个每个训练大模型的人都天天打交道的东西——交叉熵:训 GPT 时屏幕上不断往下掉的那个 loss,本质就是把今天的"报数"从单个字符,变成对整个概率分布求平均。下一篇我们就去把它拆开。
一个 0.8M 的模型,把我看了很多年的公式逼成了能心算的数字。这大概就是"用自己的数据学习"最值钱的地方。